⚡ CAPÍTULO 16: VIEWS, ÍNDICES E OTIMIZAÇÃO DE CONSULTAS
🎯 Objetivos de Aprendizagem
Ao final deste capítulo (estimativa: 2 horas de estudo autoguiado), você será capaz de:
- 🔹 Compreender a anatomia de Índices B-Tree, Hash, GIN e GiST e o impacto do custo de escrita (Write Overhead).
- 🔹 Analisar planos de execução de consultas utilizando
EXPLAIN ANALYZE(Seq Scan vs Index Scan). - 🔹 Criar e gerenciar Visões Lógicas (
CREATE VIEW) e Visões Materializadas (MATERIALIZED VIEW) com atualização periódica. - 🔹 Otimizar a arquitetura de persistência reduzindo leituras de disco no Buffer Pool.
Escrever um SQL que devolve o resultado correto é fácil. Escrever um SQL que devolve o resultado correto em 3 milissegundos sob um banco com 10 milhões de linhas é o que separa um programador iniciante de um Arquiteto de Software. 🛡️🧩
🏢 O Cenário Prático (Seu Desafio)
Na TecProExpress, a tabela de Pacotes atingiu 5 milhões de registros. A busca no painel do usuário ("Procurar pacote pelo Código de Rastreio") começou a demorar 8 segundos para responder. Os clientes estão reclamando no Reclame Aqui. Além disso, o RH pediu um relatório com os dados dos estagiários, mas o banco se recusou a dar acesso à tabela original, pois nela constam salários confidenciais.
"Seu desafio é criar uma
VIEWcega para proteger os salários do RH e implementar umÍndice(Index) no Código de Rastreio para derrubar o tempo de busca da tabela de pacotes de 8 segundos para 3 milissegundos!"
🧠 Fundamentos 1: O Encapsulamento (VIEW)
Uma VIEW (Visão) é uma tabela virtual. Ela não armazena dados físicos no HD. Ela armazena apenas a "lógica" de um SELECT.
- Segurança: Você pode criar uma VIEW que esconde a coluna "Salario" da tabela original e dar permissão para o usuário ler apenas essa VIEW.
- Abstração: Se você tem um relatório que exige 5
JOINssuper complexos, você pode salvar tudo isso em umaVIEW. O desenvolvedor frontend apenas faráSELECT * FROM nome_da_view;.
🛠️ Criando a Visão do RH
-- DDL Rápido: A tabela original (Intocável)
-- CREATE TABLE funcionario (id INT, nome VARCHAR(50), salario DECIMAL(10,2));

-- Criando a Visão Segura (Ignoramos o salário de propósito)
CREATE VIEW vw_funcionarios_rh AS
SELECT id, nome FROM funcionario;

-- Como o usuário (RH) irá consultar:
SELECT * FROM vw_funcionarios_rh;
🧠 Fundamentos 2: O Acelerador (Índices)
Quando você manda o SGBD procurar o código de rastreio 'BR123', e a tabela não tem Índice, o banco faz um Full Table Scan (Ele lê a linha 1, depois a linha 2... até a linha 5.000.000). Isso é terrível.
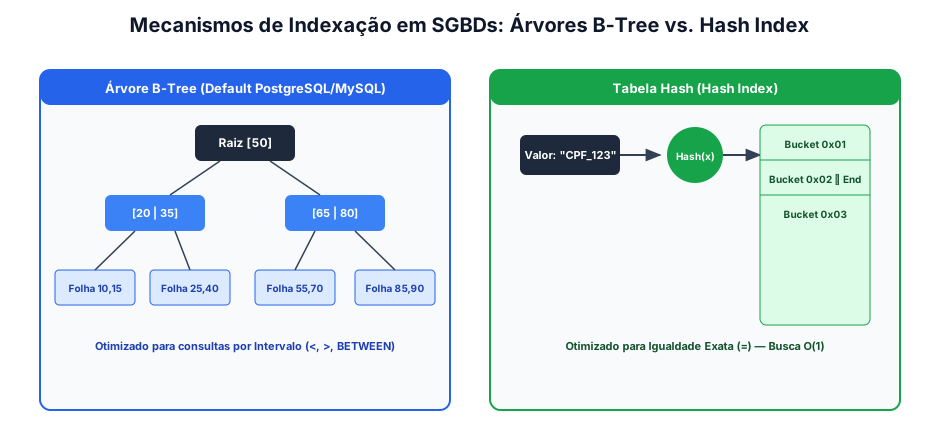
Um Índice (Index) é uma cópia organizada de uma coluna específica, guardada em uma árvore de busca (B-Tree). Funciona como o índice remissivo no final de um livro.
📊 Comparação de Busca
flowchart LR
    A["Tabela sem Índice<br/>(Lê 5 milhões de linhas)"] -->|O(N)| B["Demora 8 segundos"]
    C["Tabela com Índice B-Tree<br/>(Busca binária)"] -->|O(log N)| D["Demora 3 milissegundos"]
⚠️ O Preço do Índice
Se índices são tão maravilhosos, por que não colocamos em TODAS as colunas?
Porque o Índice atrasa a gravação. Toda vez que houver um INSERT ou UPDATE, o banco terá que escrever o dado na tabela e depois reorganizar a árvore do Índice.
A Regra: Tabelas com muita leitura (Consultas) exigem índices. Tabelas com muita gravação (ex: Logs de GPS em tempo real) exigem o mínimo de índices possível.
🧠 Fundamentos 3: Storage — Como os Dados Vivem no Disco
Índice e VIEW são abstrações lógicas. Por baixo delas, o SGBD precisa fisicamente guardar cada linha em algum lugar do disco — e essa camada física se chama Storage Engine (Motor de Armazenamento).
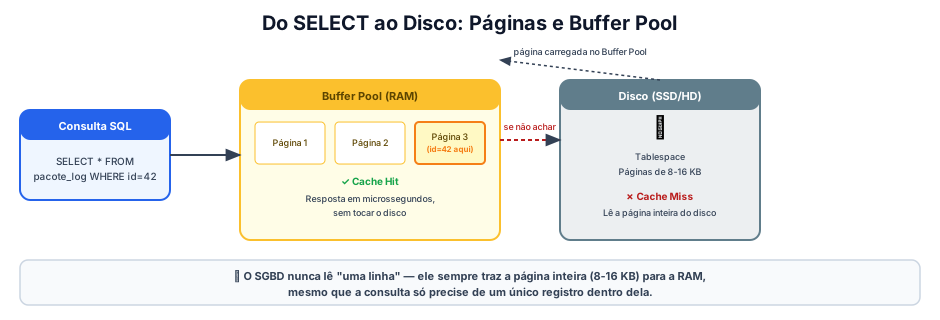
- Páginas (Pages/Blocks): O SGBD não lê "uma linha" por vez do disco — ele lê blocos de tamanho fixo (tipicamente 8 KB no PostgreSQL, 16 KB no MySQL/InnoDB), chamados páginas, que agrupam várias linhas. Um
SELECTque busca 1 linha ainda assim traz a página inteira para a memória (Buffer Pool). - Tablespaces: Estruturas lógicas que mapeiam onde, fisicamente, os arquivos de uma tabela ou índice ficam gravados no disco — permitem, por exemplo, colocar tabelas muito acessadas num SSD rápido e tabelas de histórico num disco mais lento e barato.
- Storage Engines (MySQL): O MySQL permite escolher o motor por tabela —
InnoDB(padrão, transacional, com suporte aFOREIGN KEYeROLLBACK) vsMyISAM(mais antigo, sem transações, historicamente mais rápido só para leitura pura). - Buffer Pool / Cache: Área de memória RAM onde o SGBD mantém as páginas mais usadas, para evitar ler do disco (muito mais lento) a cada consulta repetida.
💾 Do SELECT ao Disco
flowchart LR
    Q["SELECT * FROM pacote_log<br/>WHERE id = 42"] --> BP{"Página está no<br/>Buffer Pool (RAM)?"}
    BP -->|Sim: Cache Hit| R["Resposta em microssegundos"]
    BP -->|Não: Cache Miss| DISK[("Lê a Página do Disco (SSD/HD)")]
    DISK --> BP
⚠️ Por que isso importa na prática: é por causa do conceito de página que um índice em uma coluna de baixa seletividade (ex.: uma coluna
ativocom sótrue/false) muitas vezes não ajuda — o SGBD acaba lendo quase todas as páginas de qualquer jeito, e o Otimizador de Consultas prefere ignorar o índice e fazer Full Table Scan.
📖 Exemplo Guiado: Otimizando o Rastreio (EXPLAIN)
O comando EXPLAIN é a ferramenta de raio-x do SGBD. Ele não executa a consulta, ele te diz o "Plano Matemático" que o SGBD faria.
🛠️ Código do Exemplo
-- DDL Base
-- CREATE TABLE pacote_log (id INT, codigo_rastreio VARCHAR(15), status VARCHAR(20));
-- (Imagine 5 milhões de inserts aqui)

-- 1. O Diagnóstico: "Como você faria essa busca, Banco de Dados?"
EXPLAIN SELECT * FROM pacote_log WHERE codigo_rastreio = 'BR123';
-- O SGBD responderá: type = "ALL" (Ele vai ler TODAS as linhas).

-- 2. A Cura (DDL de Otimização)
CREATE INDEX idx_pacote_rastreio ON pacote_log(codigo_rastreio);

-- 3. O Novo Diagnóstico
EXPLAIN SELECT * FROM pacote_log WHERE codigo_rastreio = 'BR123';
-- O SGBD responderá: type = "ref" (Usando o Índice). Velocidade máxima atingida!
🛠️ Prática Obrigatória: Abstração e Velocidade
Cenário: O sistema de relatórios da TecProExpress.
- Crie a tabela
faturamentocomid_venda,data_venda,nome_clienteevalor_lucro. - Crie uma
VIEWchamadavw_vendas_publicasque mostre apenas a data e o cliente (escondendo o lucro da equipe de vendas). - Crie um
INDEXna colunadata_vendapara acelerar os relatórios de fechamento mensal.
🚀 Script de Seed (Gabarito de Otimização)
-- 1. Tabela Original (DDL)
CREATE TABLE faturamento (
    id_venda INT PRIMARY KEY,
    data_venda DATE,
    nome_cliente VARCHAR(100),
    valor_lucro DECIMAL(15,2)
);

-- 2. View Segura (DQL encapsulada em DDL)
CREATE VIEW vw_vendas_publicas AS
SELECT data_venda, nome_cliente
FROM faturamento;

-- 3. Índice Estratégico (DDL)
CREATE INDEX idx_data_fechamento ON faturamento(data_venda);
💻 Ponte Prática: Do SQL Manual ao SQLAlchemy 2.0 ORM
Como o SQLAlchemy 2.0 define Índices B-Tree, Views e permite inspecionar o plano de execução via EXPLAIN em Python?
🔴 1. A Abordagem Manual (Filtros sem Índices e Full Scan Lento)
Sem índices, qualquer busca por código de rastreio varre a tabela inteira do primeiro ao último registro:
# ❌ ABORDAGEM SEM ÍNDICE: Full Table Scan a cada consulta
cursor.execute("SELECT * FROM pacotes WHERE codigo_rastreio = 'BR998877';") # ⚠️ O(N) no tempo de resposta!
🟢 2. A Abordagem com SQLAlchemy 2.0 (Declaração de Índices B-Tree)
Com o SQLAlchemy 2.0, declaramos index=True ou criamos objetos Index() compostos nos metadados. O banco constrói a árvore B-Tree e reduz o tempo de busca para $O(\log N)$:
# ✅ ABORDAGEM MODERNA COM SQLALCHEMY 2.0: Índices B-Tree Declarativos
from sqlalchemy import create_engine, String, Float, Integer, Index, select, text
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

class Base(DeclarativeBase):
    pass

class PacoteIndexModel(Base):
    __tablename__ = "pacotes_indexados"
    __table_args__ = (
        Index("idx_pacote_codigo_btree", "codigo_rastreio"), # Índice B-Tree explícito
    )

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    codigo_rastreio: Mapped[str] = mapped_column(String(20), nullable=False)
    peso_kg: Mapped[float] = mapped_column(Float, nullable=False)
    status: Mapped[str] = mapped_column(String(20), default="EM_TRANSITO")

    def __repr__(self) -> str:
        return f"PacoteIndex(id={self.id}, cod='{self.codigo_rastreio}', status='{self.status}')"
🛠️ Mini-Projeto 16 (BD): Benchmark de Performance e Auditoria com EXPLAIN
Objetivo: Popular uma base com massa de registros e inspecionar o plano de execução via EXPLAIN QUERY PLAN comprovando o uso de índices B-Tree.
📋 Pré-requisitos e Instalação
No terminal do seu ambiente virtual (PowerShell ou Bash), instale a biblioteca necessária:
pip install sqlalchemy
💻 Código Completo e Autocontido (miniprojeto_16_indices.py)
Crie o arquivo miniprojeto_16_indices.py e insira o código abaixo integralmente:
"""
Mini-Projeto 16: Benchmark de Performance e Auditoria com EXPLAIN
Curso: GTI - Banco de Dados Relacionais e Engenharia de Software
Stack: Python 3.11+ | SQLAlchemy 2.0 | SQLite
"""
import os
import time
from sqlalchemy import create_engine, String, Float, Integer, Index, select, text
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

# 1. Definição Declarativa com Índice B-Tree Explícito
class Base(DeclarativeBase):
    pass

class PacoteIndexModel(Base):
    __tablename__ = "pacotes_indexados"
    __table_args__ = (
        Index("idx_pacote_codigo_btree", "codigo_rastreio"),  # Índice B-Tree explícito
    )

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    codigo_rastreio: Mapped[str] = mapped_column(String(20), nullable=False)
    peso_kg: Mapped[float] = mapped_column(Float, nullable=False)
    status: Mapped[str] = mapped_column(String(20), default="EM_TRANSITO")

    def __repr__(self) -> str:
        return f"PacoteIndex(id={self.id}, cod='{self.codigo_rastreio}', status='{self.status}')"

# 2. Ponto de Entrada Executável
if __name__ == "__main__":
    DB_FILE = "tecpro_indices_demo.db"

    # Reset preventivo para garantir idempotência em testes repetidos
    if os.path.exists(DB_FILE):
        os.remove(DB_FILE)

    engine = create_engine(f"sqlite:///{DB_FILE}", echo=False)
    Base.metadata.create_all(bind=engine)

    print("⚡ AUDITORIA DE PERFORMANCE E ÍNDICES B-TREE - TECPROEXPRESS")
    print("=" * 65)

    # 1. Inserção em lote para teste de benchmark
    with Session(engine) as session:
        pacotes_lote = [
            PacoteIndexModel(codigo_rastreio=f"BR{i:06d}XP", peso_kg=float(i % 50 + 1))
            for i in range(1, 1001)
        ]
        session.add_all(pacotes_lote)
        session.commit()
        print("✅ 1.000 Registros inseridos no banco para benchmark!")

    # 2. Inspecionando o Plano de Execução do SQLite com EXPLAIN QUERY PLAN
    with engine.connect() as conn:
        print("\n🔍 Inspecionando Plano de Execução do Otimizador:")
        plano = conn.execute(text("EXPLAIN QUERY PLAN SELECT * FROM pacotes_indexados WHERE codigo_rastreio = 'BR000500XP';")).fetchall()
        for p in plano:
            print(f"   • Detalhe do Plano: {p[3]}")
            if "USING INDEX" in str(p[3]):
                print("   🟢 SUCESSO: Otimizador utilizou a árvore B-Tree 'idx_pacote_codigo_btree'!")

    print("=" * 65)
🚀 Como Executar
Execute o script no terminal:
python miniprojeto_16_indices.py
🖥️ Saída Esperada no Console
⚡ AUDITORIA DE PERFORMANCE E ÍNDICES B-TREE - TECPROEXPRESS
=================================================================
✅ 1.000 Registros inseridos no banco para benchmark!

🔍 Inspecionando Plano de Execução do Otimizador:
   • Detalhe do Plano: SEARCH pacotes_indexados USING INDEX idx_pacote_codigo_btree (codigo_rastreio=?)
   🟢 SUCESSO: Otimizador utilizou a árvore B-Tree 'idx_pacote_codigo_btree'!
=================================================================
💡 Checkpoint de Lógica
Dica do Engenheiro: Um erro clássico de performance é colocar o código dentro de funções (ex: WHERE YEAR(data_venda) = 2026). Quando você envolve a coluna com uma função, o SGBD é forçado a ignorar o Índice e fazer o Full Table Scan. O correto para alta velocidade é: WHERE data_venda BETWEEN '2026-01-01' AND '2026-12-31'. 🧠🛡️
🧪 Quiz de Fixação e Autoavaliação — Capítulo 16
🧪 Quiz de Fixação e Autoavaliação — Capítulo 16
1. Como um Índice B-Tree acelera uma consulta como SELECT * FROM clientes WHERE cpf = '123.456.789-00'; em uma tabela com 10 milhões de linhas?
- A) Ele lê todas as 10 milhões de linhas do disco uma por uma.
- B) Ele organiza as chaves em uma árvore balanceada de busca com complexidade $O(\log N)$, encontrando o registro em cerca de 3 a 4 leituras de páginas de memória em vez de varrer a tabela inteira (Seq Scan).
- C) Ele apaga as outras 9.999.999 linhas para deixar a busca rápida.
- D) Ele duplica o tamanho da memória RAM do servidor.
💡 Ver Resposta e Justificativa
Resposta Correta: B
Justificativa: Sem índice, o banco faz 'Sequential Scan' (lê 10 milhões de linhas). Com índice B-Tree, o ponteiro da tupla é localizado em milissegundos com pouquíssimas leituras.
2. Por que NÃO devemos criar índices em TODAS as colunas de todas as tabelas indiscriminadamente?
- A) Porque o banco bloqueia a criação de mais de 3 índices.
-
B) Porque cada índice ocupa espaço extra em disco e gera overhead de processamento: toda operação de
INSERT,UPDATEeDELETEfica mais lenta, pois o banco é forçado a atualizar a tabela e todos os seus índices associados. - C) Porque índices só funcionam em colunas de texto.
- D) Porque índices apagam os dados antigos.
💡 Ver Resposta e Justificativa
Resposta Correta: B
Justificativa: Índices aceleram leituras (SELECT), mas cobram pedágio em escritas (INSERT/UPDATE/DELETE). Crie índices apenas em colunas frequentemente usadas em filtros (WHERE), junções (JOIN) e ordenações (ORDER BY).
3. Qual a diferença entre uma VIEW tradicional e uma MATERIALIZED VIEW no PostgreSQL?
-
A) A VIEW tradicional é apenas uma query salva que reexecuta toda vez que é consultada; a MATERIALIZED VIEW calcula e grava o resultado fisicamente em disco, permitindo leituras ultrarrápidas de relatórios pesados com atualização periódica (
REFRESH). - B) A VIEW tradicional é feita em Python e a MATERIALIZED em Java.
- C) MATERIALIZED VIEW só aceita dados de áudio e vídeo.
- D) Não há nenhuma diferença técnica.
💡 Ver Resposta e Justificativa
Resposta Correta: A
Justificativa: Materialized Views são como 'caches de banco de dados': gravam o resultado pré-calculado em disco, ideais para dashboards de Business Intelligence (BI) e fechamentos contábeis.
Coloque este conhecimento em prática agora mesmo executando o roteiro autoguiado:
👉 ATIVIDADE 11: ÍNDICES E OTIMIZAÇÃO