🧬 CAPÍTULO 06: ANATOMIA DE ATRIBUTOS, DOMÍNIOS E TIPOS
🎯 Objetivos de Aprendizagem
Ao final deste capítulo (estimativa: 2 horas de estudo autoguiado), você será capaz de:
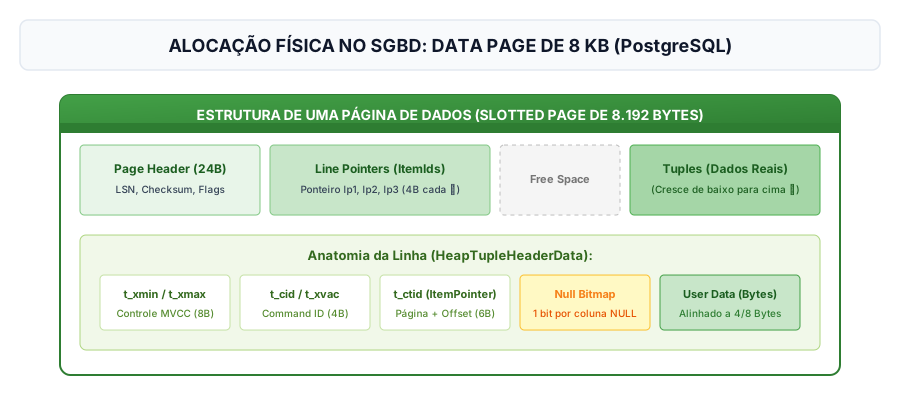
- 🔹 Analisar a alocação física de dados em disco e memória RAM (Data Pages de 8KB/16KB, Row Headers, Null Bitmaps e Data Alignment).
- 🔹 Dominar os tamanhos exatos em bits e bytes dos tipos SQL (
TINYINT8b,SMALLINT16b,INT32b,BIGINT64b,NUMERICexato eVARCHAR). - 🔹 Evitar as 4 armadilhas clássicas de conversão entre Python e SQL (Overflow numérico, Imprecisão do Float, Truncamento de String e Timestamps ingênuos).
- 🔹 Implementar tabelas híbridas com colunas JSONB nativas no SQLAlchemy 2.0.
No Modelo Relacional, a organização da informação é cirúrgica. Para que um banco de dados seja escalável e performático (como no MySQL 8.4 ou PostgreSQL 17), precisamos entender como cada "pedaço" de dado se encaixa na estrutura. 🛡️🧩
🏢 O Cenário Prático (Seu Desafio)
Você atua na TecProExpress. O setor de desenvolvimento reclamou que os IDs dos novos pacotes estão colidindo e gerando erros nas aplicações. Além disso, eles precisam de uma forma de salvar "detalhes técnicos variáveis" de eletrônicos (voltagem, cor, garantia) que mudam para cada produto, tudo sem criar mil colunas vazias.
"Seu desafio é dominar a engenharia de chaves primárias (Autoincrement/Identity) e explorar como armazenar flexibilidade no modelo relacional usando campos JSON nativos."
🧠 Fundamentos: Anatomia de um Registro
1. O Atributo (Campo)
Um Atributo é a menor unidade de informação. Ele precisa seguir as regras do seu Domínio:
- Atomicidade: O valor deve ser indivisível (ex: separar a
RuadoBairroem vez de criar um "Endereço Completo"). - Tipo de Dado:
INT,VARCHAR,DATE(Limita o que o usuário pode preencher).
2. A Chave Primária (PK)
Nenhuma tabela profissional existe sem uma Chave Primária. Ela é o DNA da tupla, garantindo a integridade dos registros.
🔍 As Duas Leis da PK:
- Unicidade: O valor nunca se repete.
- Obrigatoriedade: O campo da PK é sempre NOT NULL (Não pode ser vazio).
🛢️ Anatomia dos Tipos de Dados SQL: Bits, Bytes e Armazenamento no SGBD
Diferente do Python (onde a memória é gerenciada em objetos dinâmicos no Heap), os Sistemas Gerenciadores de Bancos de Dados (PostgreSQL, MySQL, SQLite) precisam de definições rígidas e previsíveis de tipos para gravar dados de forma contígua em Páginas de Disco e Buffer Pool (geralmente de 8 KB no PostgreSQL ou 16 KB no MySQL InnoDB).
flowchart LR
    subgraph DISK_PAGE ["🛢️ Armazenamento Físico no SGBD (Páginas de 8KB / 16KB)"]
        direction TB
        HDR["Row Header + Null Bitmap (1 bit por coluna)"]
        T1["TINYINT: 8 bits (1 byte) ➔ -128 a 127"]
        T2["SMALLINT: 16 bits (2 bytes) ➔ -32.768 a 32.767"]
        T3["INTEGER: 32 bits (4 bytes) ➔ -2,14 bilhões a +2,14 bilhões"]
        T4["BIGINT: 64 bits (8 bytes) ➔ -9 quintilhões a +9 quintilhões"]
        T5["NUMERIC(10,2): Decimal exato BCD (sem dízima binária)"]
        T6["VARCHAR(n): 1-2 bytes de tamanho + bytes do texto"]

        HDR --> T1 --> T2 --> T3 --> T4 --> T5 --> T6
    end
📊 Tabela Mestra de Tipos SQL: Bits, Bytes e Limites Físicos
| Tipo SQL | Bits | Bytes em Disco | Faixa de Valores / Limite | Como o SGBD Armazena |
|---|---|---|---|---|
BOOLEAN / BOOL | 8 bits (ou 1 bit) | 1 byte (ou bitfield) | TRUE, FALSE, NULL | Armazenado como byte simples ou em mapa de bits interno. |
TINYINT | 8 bits | 1 byte | -128 a 127 (ou 0 a 255 com UNSIGNED) | 1 byte puro em complemento de dois. |
SMALLINT | 16 bits | 2 bytes | -32.768 a 32.767 | Inteiro de 16 bits com alinhamento de 2 bytes. |
INT / INTEGER | 32 bits | 4 bytes | -2.147.483.648 a 2.147.483.647 | Inteiro padrão de 32 bits com alinhamento de 4 bytes. |
BIGINT | 64 bits | 8 bytes | -9.223.372.036.854.775.808 a +9.223.372.036.854.775.807 | Inteiro longo de 64 bits com alinhamento de 8 bytes. |
REAL / FLOAT(24) | 32 bits | 4 bytes | ~6 a 7 dígitos de precisão (IEEE 754) | Ponto flutuante binário simples de 32 bits. |
DOUBLE PRECISION / FLOAT(53) | 64 bits | 8 bytes | ~15 a 17 dígitos de precisão (IEEE 754) | Ponto flutuante binário duplo de 64 bits. |
NUMERIC(p, s) / DECIMAL(p, s) | Variável | ~4 a 16 bytes (conforme $p$) | Exato, sem dízima binária (ex: 10, 2 = 8 dígitos inteiros + 2 decimais) | Formato BCD (Binary-Coded Decimal) em blocos de 4 dígitos por 2 bytes. |
CHAR(n) | $n \times 8$ bits | $n$ bytes fixos | Exatamente $n$ caracteres | Fixo em disco: preenche com espaços em branco à direita se o texto for menor. |
VARCHAR(n) | Variável | 1 a 2 bytes + tamanho real | Até $n$ caracteres | Prefixo de tamanho (1 byte se $n \le 255$, 2 bytes se $n > 255$) + caracteres reais. |
TEXT / BLOB | Variável | Inline ou TOAST | Até 1 GB (PostgreSQL) / 4 GB (MySQL) | Se $> 2\text{ KB}$, comprimido e movido para fora da página principal (TOAST). |
DATE | 24 a 32 bits | 3 a 4 bytes | Ano 0001 a 9999 | Número inteiro representando o deslocamento de dias em relação a uma época base. |
TIMESTAMP | 64 bits | 8 bytes | Data + Hora com precisão de microsegundos | Inteiro de 64 bits em microssegundos desde 2000-01-01 (PostgreSQL). |
JSONB | Variável | Binário Estruturado | Ilimitado | Árvore binária indexada com busca direta de chaves sem reparsing. |
🧠 Como o SGBD Gerencia a Memória RAM e Disco:
- Páginas de Dados (Data Pages): O SGBD lê e grava blocos inteiros de 8 KB (PostgreSQL) ou 16 KB (MySQL). Quanto menores forem seus tipos de dados (
SMALLINTem vez deBIGINT), mais registros cabem por página, reduzindo drasticamente o I/O de disco. - Null Bitmap (Mapa de Nulos): Se uma coluna aceita
NULLe estiver vazia, o banco não gasta espaço na coluna; ele apenas ativa 1 bit no cabeçalho da linha (Row Header). - Data Alignment & Padding (Alinhamento de Memória): Processadores de 64 bits leem memória em blocos múltiplos de 8 bytes. Colocar colunas na ordem
(BIGINT, INT, SMALLINT)é mais eficiente em disco do que alternar(SMALLINT, BIGINT, SMALLINT), pois evita bytes de enchimento (padding).
🌉 A Ponte Objeto-Relacional: Tabela de Equivalências e Mapeamento
Abaixo, veja como os tipos viajam da modelagem conceitual até a memória do Python e a persistência no SGBD via SQLAlchemy 2.0:
| Conceito / Domínio | SQL (PostgreSQL / SQLite) | Python POO (Memória RAM) | ORM (SQLAlchemy 2.0) | Tamanho no SQL |
|---|---|---|---|---|
| Identificador Curto | SMALLINT |
int |
Mapped[int] = mapped_column(SmallInteger) |
16 bits (2 bytes) |
| Chave Primária / ID Padrão | INTEGER / INT / SERIAL |
int |
Mapped[int] = mapped_column(Integer, primary_key=True) |
32 bits (4 bytes) |
| Contador de Alta Escala | BIGINT / BIGSERIAL |
int |
Mapped[int] = mapped_column(BigInteger) |
64 bits (8 bytes) |
| Texto Limitado | VARCHAR(100) |
str |
Mapped[str] = mapped_column(String(100)) |
Variável (1B + texto) |
| Valor Monetário / Contábil | NUMERIC(10,2) / DECIMAL |
Decimal (da lib decimal) |
Mapped[Decimal] = mapped_column(Numeric(10,2)) |
Exato (~5 a 8 bytes) |
| Data e Hora de Auditoria | TIMESTAMP / DATETIME |
datetime |
Mapped[datetime] = mapped_column(DateTime) |
64 bits (8 bytes) |
| Booleano / Indicador | BOOLEAN |
bool |
Mapped[bool] = mapped_column(Boolean) |
1 byte |
| Documento / Metadados | JSON / JSONB |
dict / list |
Mapped[dict[str, Any]] = mapped_column(JSON) |
Variável |
flowchart LR
    subgraph Dominio ["1. Domínio Real"]
        D["Entidade: Carro<br/>Atributo: Placa, Preço"]
    end
    subgraph Python ["2. Memória (Python POO)"]
        P["class Carro:<br/>placa: str (Heap)<br/>preco: Decimal"]
    end
    subgraph SQL ["3. Persistência (SQL DDL)"]
        S["CREATE TABLE carro (<br/>placa VARCHAR(10) PK,<br/>preco NUMERIC(10,2))"]
    end
    Dominio --> Python
    Python <== "ORM SQLAlchemy (Conversão Binária)" ==> SQL
    style Dominio fill:#e3f2fd,stroke:#1e88e5
    style Python fill:#fff8e1,stroke:#fbc02d
    style SQL fill:#e8f5e9,stroke:#43a047
⚠️ As 4 Grandes Armadilhas de Conversão Python ↔ SQL:
- Armadilha do Overflow Numérico: Em Python,
x = 10**20funciona perfeitamente (precisão arbitrária). Porém, se você tentar salvar esse valor em uma colunaINT(32 bits) ouBIGINT(64 bits), o SGBD abortará a transação comNumericValueOutOfRange. - Armadilha do Dinheiro com Float: Nunca use
floatem Python para mapear colunas financeirasNUMERIC. Use semprefrom decimal import Decimalpara evitar dízimas binárias (ex:0.1 + 0.2 = 0.30000000000000004). - Armadilha do Truncamento de String: O Python expande strings conforme a memória RAM permitir, mas se o banco tiver
VARCHAR(50), tentar gravar uma string de 51 caracteres causaráStringDataRightTruncation. - Armadilha do Fuso Horário em Timestamps: Salvar
datetime.now()ingênuo (naive) em colunasTIMESTAMP WITHOUT TIME ZONEpode causar inconsistências graves em deploys na nuvem. Use sempredatetime.now(timezone.utc)com colunasTIMESTAMPTZ.
📖 Exemplo Guiado: Autoincremento Poliglota (DDL -> DML)
A solução para o problema de IDs colidindo na TecProExpress é deixar o próprio SGBD gerenciar a numeração automática das chaves primárias.
Muitos iniciantes não sabem que a sintaxe muda radicalmente entre os bancos.
🛠️ Código no MySQL 8.4 LTS
-- DDL
CREATE TABLE pacotes_mysql (
    id INT PRIMARY KEY AUTO_INCREMENT,
    destino VARCHAR(100)
);

-- DML (O ID é gerado sozinho)
INSERT INTO pacotes_mysql (destino) VALUES ('São Paulo');
🛠️ Código no PostgreSQL 17
-- DDL
CREATE TABLE pacotes_postgres (
    id INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    destino VARCHAR(100)
);

-- DML
INSERT INTO pacotes_postgres (destino) VALUES ('Rio de Janeiro');
🔍 Detalhamento do Código:
AUTO_INCREMENTvsGENERATED ALWAYS AS IDENTITY: É essencial dominar ambos para atuar no mercado poliglota.- Note que, no
INSERT, omitimos a colunaidde propósito, pois o SGBD é o responsável pela geração.
📐 Tipos de Dados e Restrições de Domínio
1. Power Tools de Domínio
Além dos tipos básicos (Texto, Número, Data), adicionamos inteligência com restrições (Constraints):
- NOT NULL: Preenchimento obrigatório.
- UNIQUE: Valor não repetido, mas permite
NULL(ex:E-mailde marketing secundário). - CHECK: Valida lógicas (ex:
CHECK (preco > 0)).
2. JSON vs JSONB (Arquitetura Híbrida)
A resposta para a TecProExpress armazenar "detalhes técnicos variáveis" sem criar mil colunas é utilizar o poder dos SGBDs modernos que suportam Documentos JSON dentro do modelo relacional:
- MySQL JSON: Armazena e valida o texto estruturado.
- Postgres JSONB: Armazena em binário indexado. É incrivelmente rápido para filtros internos.
🛠️ Prática Obrigatória: Carga Híbrida
Cenário: A tabela de produtos avançados da TecProExpress.
- Crie a tabela
produto_hibridocom uma PK autoincremental e uma coluna chamadaespecificacoesdo tipoJSON. - Insira 2 produtos com detalhes estruturais completamente diferentes usando DML.
🚀 Script de Seed (Gabarito)
-- DDL (Sintaxe MySQL)
CREATE TABLE produto_hibrido (
    id INT PRIMARY KEY AUTO_INCREMENT,
    nome VARCHAR(100) NOT NULL,
    especificacoes JSON
);

-- DML
INSERT INTO produto_hibrido (nome, especificacoes)
VALUES ('Notebook Gamer', '{"cpu": "i7", "ram": "16GB"}');

INSERT INTO produto_hibrido (nome, especificacoes)
VALUES ('Cabo HDMI', '{"tamanho_metros": 2, "cor": "preto", "banhado_ouro": true}');
💻 Ponte Prática: Do SQL Manual ao SQLAlchemy 2.0 ORM
Como o SQLAlchemy 2.0 lida com colunas JSON nativas, autoincremento e mapeamento tipado em Python?
🔴 1. A Abordagem Manual (Serialização Manual de Strings JSON)
No modelo manual, o desenvolvedor precisa converter strings JSON na mão (json.loads/json.dumps), sem validação de integridade:
# ❌ ABORDAGEM COM SQL MANUAL: Conversão manual frágil
import sqlite3, json

conn = sqlite3.connect("catalogo_legado.db")
cursor = conn.cursor()
cursor.execute("CREATE TABLE IF NOT EXISTS prod (id INTEGER PRIMARY KEY, specs TEXT);")

# Inserção manual de string JSON:
dados_specs = {"voltagem": 220, "garantia_meses": 12}
cursor.execute("INSERT INTO prod (specs) VALUES (?);", (json.dumps(dados_specs),))
conn.commit()
🟢 2. A Abordagem com SQLAlchemy 2.0 (Coluna JSON Nativa e Tipagem)
Com o SQLAlchemy 2.0, usamos o tipo JSON nativo. O ORM converte dicionários Python diretamente em JSON no banco e restaura como dict na consulta:
# ✅ ABORDAGEM MODERNA: Mapeamento Relacional Híbrido (SQL + JSON)
from typing import Any
from sqlalchemy import create_engine, String, Integer, JSON, select
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

class Base(DeclarativeBase):
    pass

class ProdutoHibridoModel(Base):
    """Tabela relacional com coluna JSON híbrida para especificações variáveis."""
    __tablename__ = "produtos_hibridos"

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    nome: Mapped[str] = mapped_column(String(100), nullable=False)
    especificacoes: Mapped[dict[str, Any]] = mapped_column(JSON, nullable=False)

    def __repr__(self) -> str:
        return f"Produto(id={self.id}, nome='{self.nome}', specs={self.especificacoes})"
🛠️ Mini-Projeto 06 (BD): Catálogo Híbrido de Produtos com JSON
Objetivo: Criar e consultar registros com estruturas de especificações heterogêneas utilizando a coluna JSON do SQLAlchemy 2.0.
📋 Pré-requisitos e Instalação
No terminal do seu ambiente virtual (PowerShell ou Bash), instale a biblioteca necessária:
pip install sqlalchemy
💻 Código Completo e Autocontido (miniprojeto_06_hibrido.py)
Crie o arquivo miniprojeto_06_hibrido.py e insira o código abaixo integralmente:
"""
Mini-Projeto 06: Catálogo Híbrido de Produtos com JSON
Curso: GTI - Banco de Dados Relacionais e Engenharia de Software
Stack: Python 3.11+ | SQLAlchemy 2.0 | SQLite
"""
import os
from typing import Any
from sqlalchemy import create_engine, String, Integer, JSON, select
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

# 1. Definição Declarativa do Schema Híbrido
class Base(DeclarativeBase):
    pass

class ProdutoHibridoModel(Base):
    """Tabela relacional com coluna JSON híbrida para especificações variáveis."""
    __tablename__ = "produtos_hibridos"

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    nome: Mapped[str] = mapped_column(String(100), nullable=False)
    especificacoes: Mapped[dict[str, Any]] = mapped_column(JSON, nullable=False)

    def __repr__(self) -> str:
        return f"Produto(id={self.id}, nome='{self.nome}', specs={self.especificacoes})"

# 2. Ponto de Entrada Executável
if __name__ == "__main__":
    DB_FILE = "tecpro_produtos.db"

    # Reset preventivo para garantir idempotência em testes repetidos
    if os.path.exists(DB_FILE):
        os.remove(DB_FILE)

    engine = create_engine(f"sqlite:///{DB_FILE}", echo=False)
    Base.metadata.create_all(bind=engine)

    print("🧬 CATÁLOGO HÍBRIDO RELACIONAL + JSON (TECPROEXPRESS)")
    print("=" * 65)

    # 1. Inserindo produtos com especificações completamente distintas
    with Session(engine) as session:
        p1 = ProdutoHibridoModel(
            nome="Notebook Dell Latitude",
            especificacoes={"processador": "Core i7", "ram_gb": 16, "ssd_gb": 512, "voltagem": "Bivolt"}
        )
        p2 = ProdutoHibridoModel(
            nome="Cabo de Rede Furukawa Cat6",
            especificacoes={"comprimento_metros": 50, "blindagem": "STP", "cor": "Azul"}
        )
        p3 = ProdutoHibridoModel(
            nome="Sensor de Temperatura IoT",
            especificacoes={"bateria_duracao_anos": 3, "protocolo": "MQTT", "faixa_celsius": [-20, 70]}
        )

        session.add_all([p1, p2, p3])
        session.commit()
        print("✅ 3 Produtos híbridos inseridos com sucesso!")

    # 2. Consultando e acessando chaves JSON como objetos Python nativos
    print("\n🔍 Consultando catálogo e lendo atributos JSON diretamente:")
    with Session(engine) as session:
        produtos = session.scalars(select(ProdutoHibridoModel)).all()
        for p in produtos:
            print(f"\n📦 {p.nome} (ID: {p.id})")
            for chave, valor in p.especificacoes.items():
                print(f"   • {chave}: {valor}")
    print("=" * 65)
🚀 Como Executar
Execute o script no terminal:
python miniprojeto_06_hibrido.py
🖥️ Saída Esperada no Console
🧬 CATÁLOGO HÍBRIDO RELACIONAL + JSON (TECPROEXPRESS)
=================================================================
✅ 3 Produtos híbridos inseridos com sucesso!

🔍 Consultando catálogo e lendo atributos JSON diretamente:

📦 Notebook Dell Latitude (ID: 1)
   • processador: Core i7
   • ram_gb: 16
   • ssd_gb: 512
   • voltagem: Bivolt

📦 Cabo de Rede Furukawa Cat6 (ID: 2)
   • comprimento_metros: 50
   • blindagem: STP
   • cor: Azul

📦 Sensor de Temperatura IoT (ID: 3)
   • bateria_duracao_anos: 3
   • protocolo: MQTT
   • faixa_celsius: [-20, 70]
=================================================================
💡 Checkpoint de Lógica
Dica do Arquiteto: Evite usar BIGINT para tudo. No MySQL, se um campo nunca passará de 255 valores (ex: status de um pedido, idade), use TINYINT. Economia de espaço é sinônimo de performance em larga escala! 🚀🛡️
🧪 Quiz de Fixação e Autoavaliação — Capítulo 06
🧪 Quiz de Fixação e Autoavaliação — Capítulo 06
1. Por que valores monetários e financeiros NUNCA devem ser armazenados usando FLOAT ou DOUBLE?
- A) Porque o banco rejeita salvar números com vírgula.
-
B) Porque
FLOATusa representação binária IEEE 754 com aproximações, acumulando dízimas e erros de centavos (ex:0.1 + 0.2 = 0.30000000000000004). Deve-se usar sempreNUMERIC(p,s)/DECIMAL(p,s). -
C) Porque
FLOATgasta mais memória queNUMERIC. -
D) Porque
FLOATsó aceita números inteiros.
💡 Ver Resposta e Justificativa
Resposta Correta: B
Justificativa: Bancos e sistemas fiscais exigem representação decimal exata (BCD) com NUMERIC(10,2) no banco e from decimal import Decimal no Python.
2. No armazenamento físico do SGBD, como o banco registra que uma coluna opcional contém valor NULL?
- A) Gravando o texto 'NULL' ocupando 4 bytes na coluna.
- B) Ativando exatamente 1 bit no mapa de bits (Null Bitmap) localizado no cabeçalho da linha, sem gastar nenhum byte extra de espaço na coluna.
- C) Apagando a tabela inteira do disco.
- D) Preenchendo a coluna com zeros binários.
💡 Ver Resposta e Justificativa
Resposta Correta: B
Justificativa: SGBDs são altamente eficientes: campos NULL não ocupam espaço na área de dados da linha; sua presença é sinalizada em um bitmask no cabeçalho da tupla.
3. Qual a diferença entre os tipos de texto CHAR(10) e VARCHAR(10)?
-
A)
CHAR(10)é sempre fixo em 10 bytes (preenche com espaços se o texto tiver 3 letras);VARCHAR(10)gasta apenas o tamanho real das letras + 1 byte de cabeçalho de comprimento. -
B)
CHARsó aceita números eVARCHARsó aceita letras. -
C)
VARCHARapaga o texto após 10 dias. - D) Não há nenhuma diferença prática.
💡 Ver Resposta e Justificativa
Resposta Correta: A
Justificativa: Use CHAR(n) apenas quando o tamanho for rigidamente fixo (ex: UF CHAR(2), Hash SHA-256 CHAR(64)). Para dados de tamanho variável (nomes, emails), use VARCHAR(n).
Coloque este conhecimento em prática agora mesmo executando o roteiro autoguiado:
👉 ATIVIDADE 06: SQL DML (MANIPULAÇÃO DE DADOS)