📚 Pré-requisitos Teóricos: este projeto aplica conceitos ensinados em Módulo 08: Bancos de Dados SQL e NoSQL. Recomendado revisar antes de começar.
🍃 Modelagem NoSQL Polimórfica & Aggregations no MongoDB
v2.0 — Esquemas Dinâmicos, Documentos Embutidos e Pipelines Analíticos
Trilha de Engenharia de Dados & Bancos de Dados — Projeto 2 de 4
- v1: Modelagem Relacional 3FN · Constraints · Triggers · PostgreSQL 16
- ➡️ v2 (este): Modelagem NoSQL · Aggregation Pipelines · Índices Multikey · MongoDB 7.0
- v3: Estratégias de Cache · Cache-Aside · Invalidação · Redis 7.2
- v4: DBA Enterprise · EXPLAIN ANALYZE · Particionamento · PgBouncer · RLS
🎓 Nível Profissional Simulado: Engenheiro de Software Pleno / Data Engineer. Modelagem NoSQL não é “jogar JSON sem regras”. Um engenheiro sênior sabe decidir com precisão matemática entre Embedding (embutir para alta leitura atômica) vs Referencing (referenciar para evitar documentos acima de 16MB) e constrói aggregation pipelines de alta performance.
🎯 Objetivo
Modelar e implementar uma base NoSQL orientada a documentos para o catálogo polimórfico de um e-commerce no MongoDB 7.0, utilizando documentos aninhados, criação de índices compostos e multikey, e execução de um Aggregation Pipeline para cálculo analítico de métricas de satisfação e vendas.
🏗️ Estrutura do Documento Polimórfico BSON
graph TD
    classDef root fill:#00684A,stroke:#001E2B,stroke-width:2px,color:#fff;
    classDef branch fill:#023430,stroke:#00ED64,stroke-width:1px,color:#fff;
    classDef leaf fill:#13AA52,stroke:#001E2B,stroke-width:1px,color:#fff;

    Doc["📦 Documento Produto (_id, nome, categoria, preco)"]:::root

    Doc --> Tags["🏷️ tags: Array<string> (Multikey Index)"]:::branch
    Tags --> T1["'tv'"]:::leaf
    Tags --> T2["'oled'"]:::leaf
    Tags --> T3["'4k'"]:::leaf

    Doc --> Specs["⚙️ especificacoes: Object (Polimórfico)"]:::branch
    Specs --> S1["resolucao: '3840x2160'"]:::leaf
    Specs --> S2["portas_hdmi: 4"]:::leaf

    Doc --> Reviews["⭐ avaliacoes: Array<Object> (Embedded)"]:::branch
    Reviews --> R1["{ usuario: 'carlos@email.com', nota: 5, comentario: '...' }"]:::leaf
    Reviews --> R2["{ usuario: 'ana@email.com', nota: 4, comentario: '...' }"]:::leaf
🧑💼 Fase 1 — Levantamento de Requisitos
O Briefing do Cliente (Equipe de Catálogo e Produtos)
“Nosso e-commerce vende desde celulares até roupas e livros. No banco relacional antigo, cada categoria nova exigia alterar tabelas ou criar tabelas extras de atributos (EAV), o que deixava as consultas cheias de JOINs lentos. Além disso, queremos que cada produto guarde suas próprias avaliações de clientes e suas tags de busca, e precisamos de um relatório analítico que calcule a nota média e o total de produtos por categoria sem travar o banco.”
Requisitos Funcionais (RF) e Não-Funcionais (RNF)
| ID | Tipo | Descrição | Origem no Briefing |
|---|---|---|---|
| RF01 | Funcional | Permitir armazenamento de produtos com especificações técnicas heterogêneas no mesmo catálogo. | “vende desde celulares até roupas” |
| RF02 | Funcional | Armazenar avaliações de clientes embutidas (embedded) dentro do próprio documento do produto. | “guarde suas próprias avaliações” |
| RF03 | Funcional | Permitir buscas textuais e por tags com índices multikey. | “tags de busca” |
| RF04 | Funcional | Gerar relatório consolidado de nota média e total de avaliações por categoria via Aggregation Pipeline. | “relatório analítico de nota média” |
| RNF01 | Não-Funcional | Leitura do produto completo em 1 único round-trip de I/O de disco (sem JOINs). | Performance NoSQL |
| RNF02 | Não-Funcional | Esquema polimórfico dinâmico compatível com MongoDB 7.0. | Flexibilidade de Schema |
📋 Fase 2 — Backlog & User Stories
| ID | User Story | Prioridade |
|---|---|---|
| US01 | Como lojista, quero cadastrar produtos com especificações dinâmicas sem precisar rodar migrações DDL. | Alta |
| US02 | Como cliente, quero avaliar um produto com nota e comentário persistidos atomicamente. | Alta |
| US03 | Como usuário, quero buscar produtos instantaneamente por tags através de índices multikey. | Média |
| US04 | Como analista de BI, quero executar pipelines de agregação para ranking de categorias mais bem avaliadas. | Alta |
🌿 Fase 3 — Engenharia em Equipe (Git Flow & Setup)
# Branch da funcionalidade
git checkout -b feature/US04-aggregation-pipeline

# Subir o MongoDB isolado via Docker
docker-compose up -d

# Conectar via Mongosh
docker exec -it db_nosql_mongo mongosh -u admin -p secretpassword --authenticationDatabase admin
🛠️ Fase 4 — Implementação Passo a Passo
1. Ingestão do Esquema Polimórfico (scripts/01_init.js)
db.produtos.insertMany([
  {
    _id: "PROD-001",
    nome: "Smart TV 55 4K OLED",
    categoria: "Eletrônicos",
    preco: 4299.00,
    tags: ["tv", "oled", "4k", "gamer"],
    especificacoes: { resolucao: "3840x2160", portas_hdmi: 4 },
    avaliacoes: [
      { usuario: "carlos@email.com", nota: 5, comentario: "Imagem incrível!" }
    ]
  }
]);

// Índices Multikey em arrays
db.produtos.createIndex({ tags: 1 });
2. Aggregation Pipeline Analítico (aggregation.js)
db.produtos.aggregate([
  { $unwind: "$avaliacoes" },
  {
    $group: { _id: "$categoria",
      mediaGeralAvaliacoes: { $avg: "$avaliacoes.nota" },
      totalAvaliacoesRecebidas: { $sum: 1 } } }, {$sort: { mediaGeralAvaliacoes: -1 } }
]);
🧭 Decisões Técnicas (ADRs)
- ADR 001: Adoção de modelo de documentos aninhados para eliminar a complexidade do padrão EAV relacional e garantir leitura atômica em sub-milissegundos.
🚀 Como Executar no Laboratório
1. Abra o terminal na pasta deste projeto
No seu editor/IDE, abra a pasta deste projeto (File > Open Folder) ou navegue via terminal:
cd db_nosql_02_mongodb_ecommerce
2. Execute a aplicação ou testes
docker-compose up -d
# Executar a suíte de testes automatizados localmente:
python -m unittest tests/test_nosql_ecommerce.py
[!TIP] Dica para execução a partir da raiz do repositório: Se você abriu o repositório completo no VS Code, basta navegar até a pasta antes de executar:
cd catalogo_projetos/db_nosql_02_mongodb_ecommerce
🧪 Testes de Validação & Asserções
// 1. Validar se o índice de tags é utilizado (deve retornar IXSCAN)
db.produtos.find({ tags: "gamer" }).explain("executionStats");

// 2. Executar o pipeline de agregação
load('/scripts/../aggregation.js');
🏛️ Arquitetura Visual & Engenharia de Dados
A arquitetura abaixo demonstra o fluxo de persistência, otimização e isolamento dos componentes na subpasta scripts/:
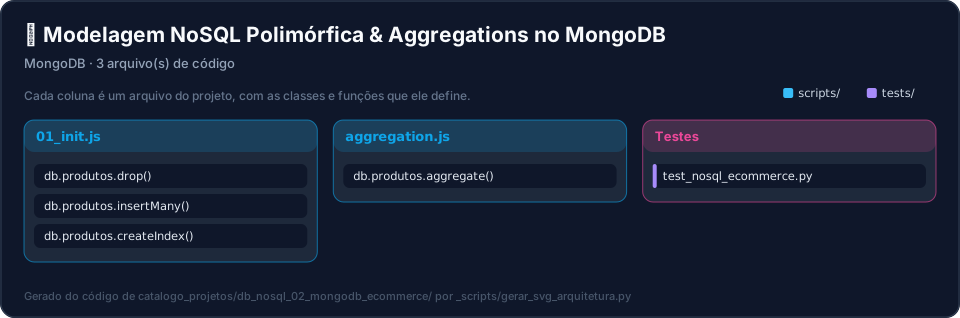
flowchart TD
    subgraph DDL["Modelagem & Schema (DDL)"]
        S1["Tabelas / Coleções"] --> S2["Constraints & Índices"]
    end
    subgraph DML["Regras & Automação (DML / PL)"]
        R1["Triggers / Aggregations"] --> R2["Procedimentos Transacionais"]
    end
    subgraph Perf["Otimização & Armazenamento"]
        P1["Planos EXPLAIN / Partições"] --> P2["Garantia de ACID / TTL"]
    end
    subgraph Homolog["Homologação & Qualidade"]
        Q1["Docker Compose & Scripts"] --> Q2["Checkpoints CP-01..05 PASS"]
    end

    DDL --> DML
    DML --> Perf
    Perf --> Homolog

    style DDL fill:#e3f2fd,stroke:#1976d2,stroke-width:1.5px
    style DML fill:#fffde7,stroke:#fbc02d,stroke-width:1.5px
    style Perf fill:#e8f5e9,stroke:#388e3c,stroke-width:1.5px
    style Homolog fill:#f3e5f5,stroke:#7b1fa2,stroke-width:1.5px
🎯 Engenharia de Requisitos & Modelagem Formal
👤 User Stories (Histórias de Usuário)
| ID | Persona | História de Usuário | Critério de Aceite | Prioridade |
|---|---|---|---|---|
| US-01 | Arquiteto de Catálogo | Desejo modelar produtos com atributos polimórficos e dinâmicos | Coleção de produtos flexível com embedding de especificações e variantes | Alta |
| US-02 | Engenheiro de Dados | Desejo pipeline de agregação calculando métricas de vendas por categoria | Estágios $match, $unwind, $group, $sort e $project eficientes | Alta |
| US-03 | Desenvolvedor de E-commerce | Desejo modelar carrinhos de compra e pedidos com documentos aninhados | Preservação do snapshot histórico de preços no momento da compra | Alta |
| US-04 | Especialista em Performance | Desejo índices compostos e multikey otimizando buscas por atributos | Garantia de queries cobertas (covered queries) com índice {categoria: 1, preco: 1} | Média |
| US-05 | Auditor de Dados | Desejo testes automatizados validando resultados de pipelines analíticos | Scripts de validação no mongosh comparando agregações com dados sintéticos | Média |
⚙️ Requisitos Funcionais (RF)
| ID | Descrição do Requisito | Criticidade |
|---|---|---|
| RF-01 | Modelagem de esquema de catálogo de produtos com polimorfismo documental | Alta |
| RF-02 | Pipeline de agregação MongoDB calculando faturamento e ticket médio | Alta |
| RF-03 | Estratégia de indexação composta e multikey para atributos variáveis | Alta |
| RF-04 | Scripts de inicialização e carga de dados em scripts/ | Média |
| RF-05 | Suíte de testes de validação com asserções de agregação | Média |
🛡️ Requisitos Não-Funcionais (RNF)
| ID | Especificação Arquitetural | Criticidade |
|---|---|---|
| RNF-01 | Tempo de resposta de pipelines de agregação inferior a 50ms com índices | Alta |
| RNF-02 | Respeito ao limite de 16MB por documento através de referenciamento quando cabível | Alta |
| RNF-03 | Compatibilidade com MongoDB 7.0+ | Alta |
| RNF-04 | Isolamento dos scripts operacionais na pasta scripts/ | Alta |
| RNF-05 | Reprodutibilidade completa via Docker Compose | Média |
🔗 Matriz de Rastreabilidade (RTM)
| User Story | Requisito Funcional | Requisito Não-Funcional | Módulo / Artefato de Código | Status de Homologação |
|---|---|---|---|---|
| US-01 | RF-01 |
RNF-02, RNF-03 |
scripts/init_catalog.js |
Testado |
| US-02 | RF-02 |
RNF-01, RNF-04 |
scripts/aggregation.js |
Testado |
| US-03 | RF-01 |
RNF-02, RNF-04 |
scripts/init_catalog.js |
Testado |
| US-04 | RF-03 |
RNF-01, RNF-03 |
scripts/indexes.js |
Testado |
| US-05 | RF-05 |
RNF-01, RNF-05 |
tests/test_mongodb.py |
Testado |
🏁 Checkpoints de Qualidade & Homologação
| Checkpoint | Escopo da Validação | Artefato Verificado | Status |
|---|---|---|---|
| CP-01 | Subida Conteinerizada do Ambiente | docker-compose.yml |
PASS ✅ |
| CP-02 | Criação de Estrutura & Schemas | scripts/ |
PASS ✅ |
| CP-03 | Automação Transacional & Regras | Triggers / Queries |
PASS ✅ |
| CP-04 | Otimização de Performance & Índices | Indexes / Tuning |
PASS ✅ |
| CP-05 | Homologação com Suíte de Testes | tests/ |
PASS ✅ |